Distância de Levenshtein
Como Algoritmos Medem a Semelhança Entre Textos
Você já parou para pensar em como o seu buscador entende o que você quis dizer mesmo quando você digita "algoritmo" como "algrtimu"? Ou como ferramentas de autocorreção no smartphone corrigem erros de digitação em milissegundos?
Por trás dessas mágicas cotidianas do processamento de linguagem natural (PLN) e da engenharia de software está um conceito clássico e incrivelmente elegante: a Distância de Levenshtein.
Desenvolvida pelo cientista soviético Vladimir Levenshtein em 1965, essa métrica de distância de edição é uma das ferramentas mais fundamentais para medir a diferença entre duas cadeias de caracteres (strings). Neste artigo, vamos mergulhar no funcionamento matemático do algoritmo, entender suas aplicações práticas e ver como implementá-lo.
O Que É a Distância de Levenshtein?
Em termos simples, a Distância de Levenshtein entre duas palavras é o número mínimo de edições de um único caractere necessárias para transformar uma string na outra.
As operações permitidas para essa transformação são apenas três:
- Inserção: Adicionar um caractere.
- Remoção: Excluir um caractere.
- Substituição: Trocar um caractere por outro.
Exemplo Prático:
Vamos calcular a distância entre a palavra "CASA" e "CAPA":
- Para transformar "CASA" em "CAPA", precisamos apenas substituir o
'S'pelo'P'. - Distância = 1.
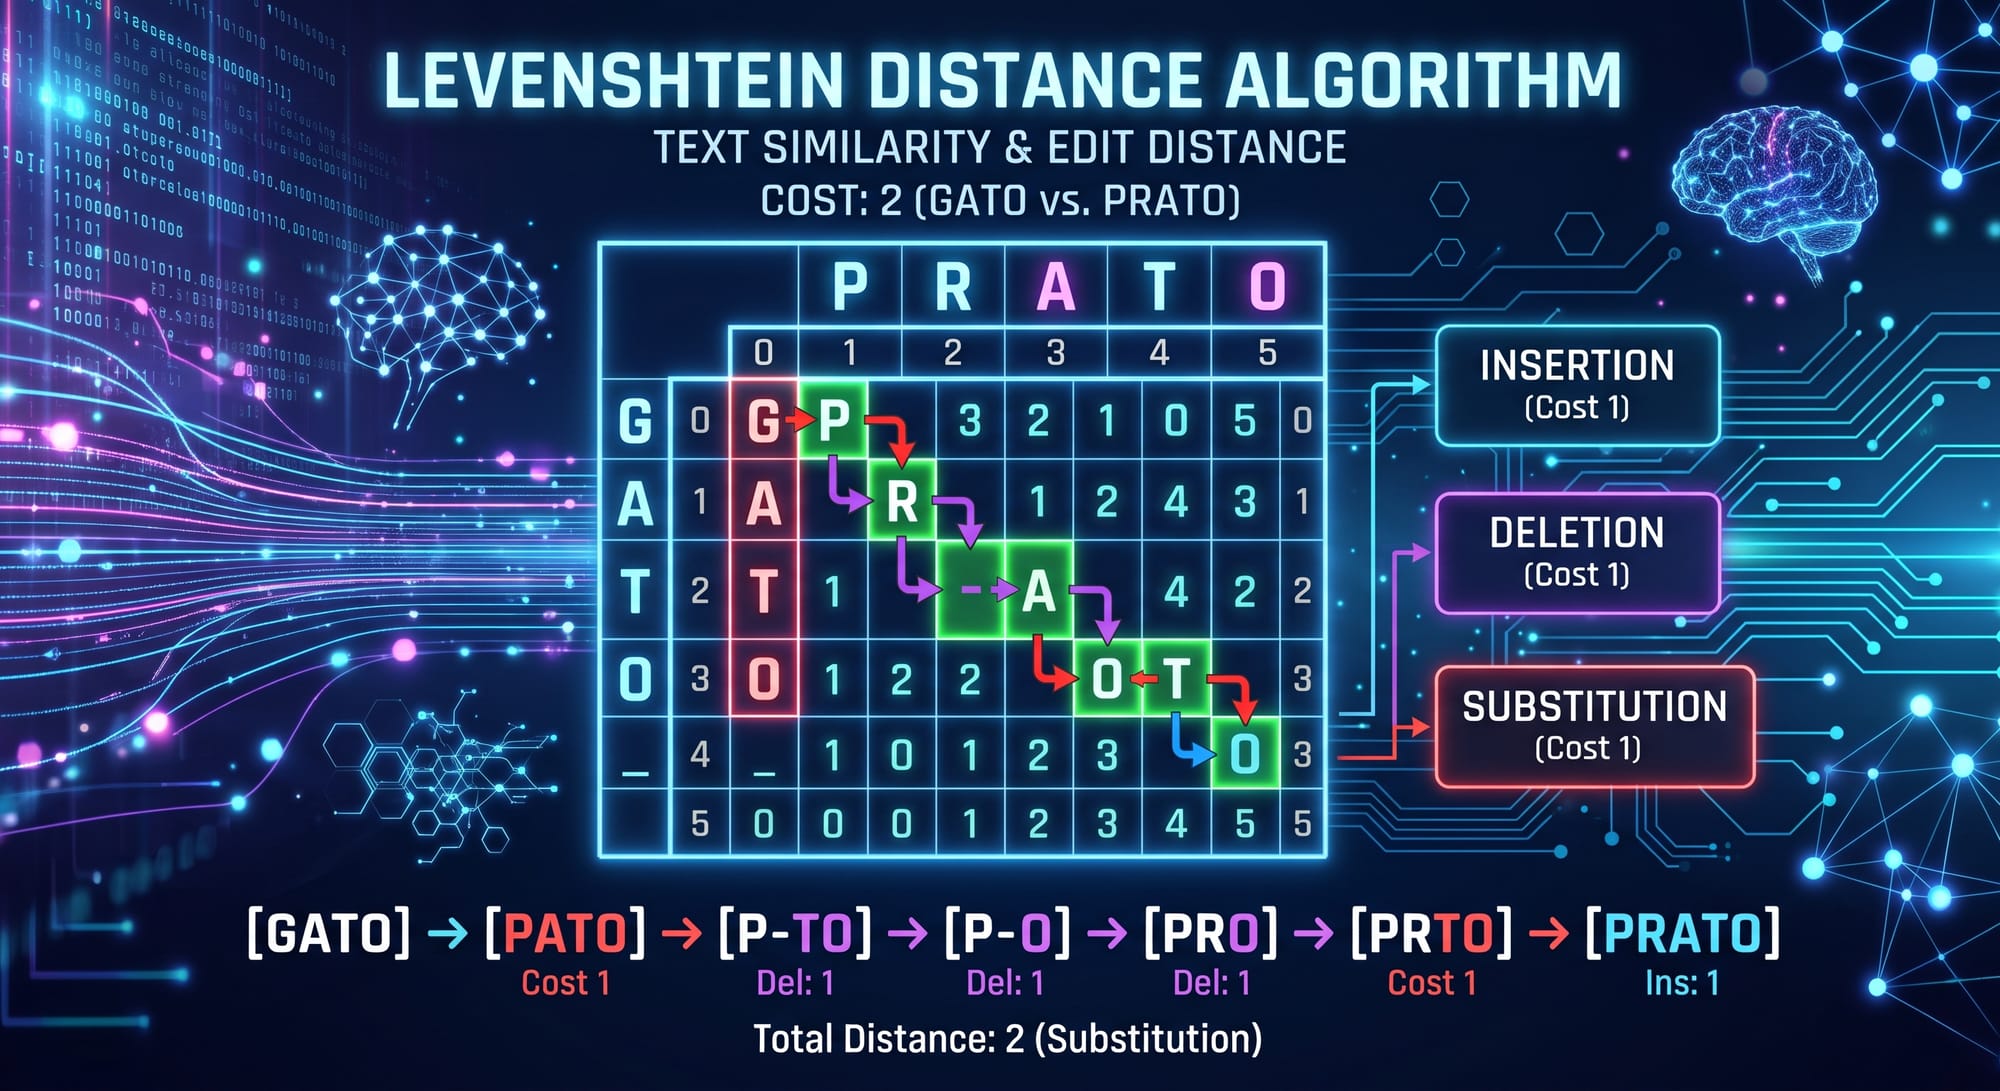
Agora, considere transformar "GATO" em "PRATO":
- Substituir
'G'por'P'-> PATO - Inserir
'R'após o'P'-> PRATO
- Distância = 2.
Como Funciona o Algoritmo: Programação Dinâmica
Calcular a distância para palavras curtas de cabeça é fácil. No entanto, comparar textos longos ou processar milhões de palavras em um dicionário exige uma abordagem computacional eficiente.
A solução clássica utiliza Programação Dinâmica, construindo uma matriz onde as linhas representam os caracteres da primeira string e as colunas representam os caracteres da segunda.
A Fórmula Matemática
A distância entre um prefixo da string $A$ de tamanho $i$ e um prefixo da string $B$ de tamanho $j$ é dada por:
<div style="max-width: 100%; overflow-x: auto;"> $$ D(i, j) = \begin{cases} i & \text{se } j = 0 \\ j & \text{se } i = 0 \\ D(i-1, j-1) & \text{se } A[i] = B[j] \\ 1 + \min \begin{cases} D(i-1, j) & \text{(Remoção)} \\ D(i, j-1) & \text{(Inserção)} \\ D(i-1, j-1) & \text{(Substituição)} \end{cases} & \text{se } A[i] \neq B[j] \end{cases} $$ </div>
A complexidade de tempo para resolver essa matriz é $O(m \times n)$, onde $m$ e $n$ são os tamanhos das duas strings.
Implementação em Python
Abaixo está uma implementação limpa e direta utilizando o algoritmo clássico com matriz:
def distancia_levenshtein(s1: str, s2: str) -> int:
    len_s1, len_s2 = len(s1), len(s2)

    # Criar a matriz de tamanho (len_s1 + 1) x (len_s2 + 1)
    dp = [[0] * (len_s2 + 1) for _ in range(len_s1 + 1)]

    # Preencher a primeira coluna e a primeira linha
    for i in range(len_s1 + 1):
        dp[i][0] = i
    for j in range(len_s2 + 1):
        dp[0][j] = j

    # Preencher o restante da matriz
    for i in range(1, len_s1 + 1):
        for j in range(1, len_s2 + 1):
            if s1[i - 1] == s2[j - 1]:
                custo_substituicao = 0
            else:
                custo_substituicao = 1

            dp[i][j] = min(
                dp[i - 1][j] + 1,        # Remoção
                dp[i][j - 1] + 1,        # Inserção
                dp[i - 1][j - 1] + custo_substituicao  # Substituição
            )

    return dp[len_s1][len_s2]

# Teste
print(distancia_levenshtein("GATO", "PRATO"))  # Saída: 2
Onde a Distância de Levenshtein É Usada no Mundo Real?
Apesar de ser um algoritmo com mais de meio século de existência, sua relevância permanece altíssima na tecnologia moderna:
1. Correção Ortográfica e Autocorreção
Mecanismos de busca e editores de texto usam Levenshtein (ou variações como Damerau-Levenshtein, que também conta a transposição de dois caracteres adjacentes) para sugerir a palavra correta mais próxima daquela que o usuário digitou com erro.
2. Bioinformática e Sequenciamento Genético
No alinhamento de sequências de DNA e RNA, as bases nitrogenadas (A, T, C, G) são tratadas como caracteres. A distância de edição mede o grau de mutação ou variação genética entre diferentes organismos ou genes.
3. Deduplicação de Dados e Entidades (Fuzzy Matching)
Em bancos de dados corporativos ou data lakes, é comum encontrar registros duplicados com variações de grafia (ex: "Carlos Silva" vs "Carlos da Silva"). A métrica permite agrupar e limpar dados com correspondência aproximada (fuzzy search).
4. Análise de plágio e verificação de código
Comparar o grau de similaridade entre documentos ou arquivos de código-fonte para identificar trechos copiados ou refatorados.
Limitações e Alternativas Modernas
Embora seja excelente para correspondência exata de caracteres, a Distância de Levenshtein não entende contexto ou semântica.
Por exemplo:
- "Casa" e "Lar" possuem distância de Levenshtein alta, apesar de serem sinônimos.
- "Cachorro" e "Cachorra" possuem distância 1, mas se referem a gêneros diferentes.
Para problemas que exigem compreensão de significado em vez de apenas grafia, a indústria hoje combina a Distância de Levenshtein com modelos de Embeddings de Texto (como os usados em LLMs e LLM-based search), utilizando métricas como a Similaridade de Cosseno em espaços vetoriais.
Conclusão
A Distância de Levenshtein é um exemplo brilhante de como um conceito matemático relativamente simples pode se tornar um pilar da computação prática. Seja na busca do Google, no seu teclado do celular ou na análise do genoma humano, esse algoritmo continua garantindo que a tecnologia consiga lidar com a bagunça e a imprevisibilidade do texto humano.